Python 量化回测与绩效评估
回测(Backtesting)是在历史市场数据上模拟和评估一个交易策略的过程。
它是量化交易最关键的一环:策略在过去的表现不能保证未来,但没有历史验证的策略连讨论的资格都没有。
本篇将手写一个完整的向量化回测,计算四大绩效指标,并讲透新手最容易踩的几个回测陷阱。
回测的一般步骤
一次规范的回测,通常包含以下环节:
| 步骤 | 说明 |
|---|---|
| 定义交易策略 | 确定何时买入、卖出或持仓的规则,如均线交叉、突破、套利条件等 |
| 获取历史数据 | 取得回测区间内的价格、成交量等数据 |
| 模拟交易 | 按策略规则在历史数据上逐日生成信号并计算每笔交易的盈亏 |
| 计算绩效指标 | 统计年化收益率、最大回撤、夏普比率等,量化评估策略表现 |
| 优化与再验证 | 结果不理想时调整参数重测;结果理想时也要换一段未参与调参的数据验证 |
整个流程环环相扣,优化之后必须回到模拟环节重新验证,形成闭环:
手写第一个回测
不借助任何回测框架,直接用 pandas 把双均线策略放到 2019 至 2021 年的茅台数据上模拟一遍。
自己动手写一遍的最大好处,是看清回测的每个细节到底发生了什么:
实例
import matplotlib.pyplot as plt
# 获取回测区间数据
data = yf.download("600519.SS", start="2019-01-01", end="2021-01-01",
progress=False, multi_level_index=False)
# 计算双均线
data["SMA50"] = data["Close"].rolling(window=50).mean()
data["SMA200"] = data["Close"].rolling(window=200).mean()
# 生成信号:短期均线在上记 1(持仓),在下记 -1(空仓)
data["Signal"] = 0
data.loc[data["SMA50"] > data["SMA200"], "Signal"] = 1
data.loc[data["SMA50"] < data["SMA200"], "Signal"] = -1
# 计算每日收益率
data["Daily_Return"] = data["Close"].pct_change()
# 关键一行:用前一天的信号乘以今天的收益
# shift(1) 把信号整体后移一天,代表"今天收盘算出信号,明天才能执行"
data["Strategy_Return"] = data["Signal"].shift(1) * data["Daily_Return"]
# 计算策略与买入持有的累计净值
data["Cum_Strategy"] = (1 + data["Strategy_Return"]).cumprod()
data["Cum_Stock"] = data["Close"] / data["Close"].iloc[0]
# 绘制累计收益曲线
plt.figure(figsize=(12, 6))
plt.plot(data["Cum_Strategy"], label="Strategy Cumulative Return", color="b")
plt.plot(data["Cum_Stock"], label="Stock Cumulative Return", color="g")
plt.title("Cumulative Return of Strategy vs. Stock")
plt.xlabel("Date")
plt.ylabel("Cumulative Return")
plt.legend()
plt.show()
执行以上代码,输出的图表如下,蓝线是策略净值,绿线是买入持有净值:
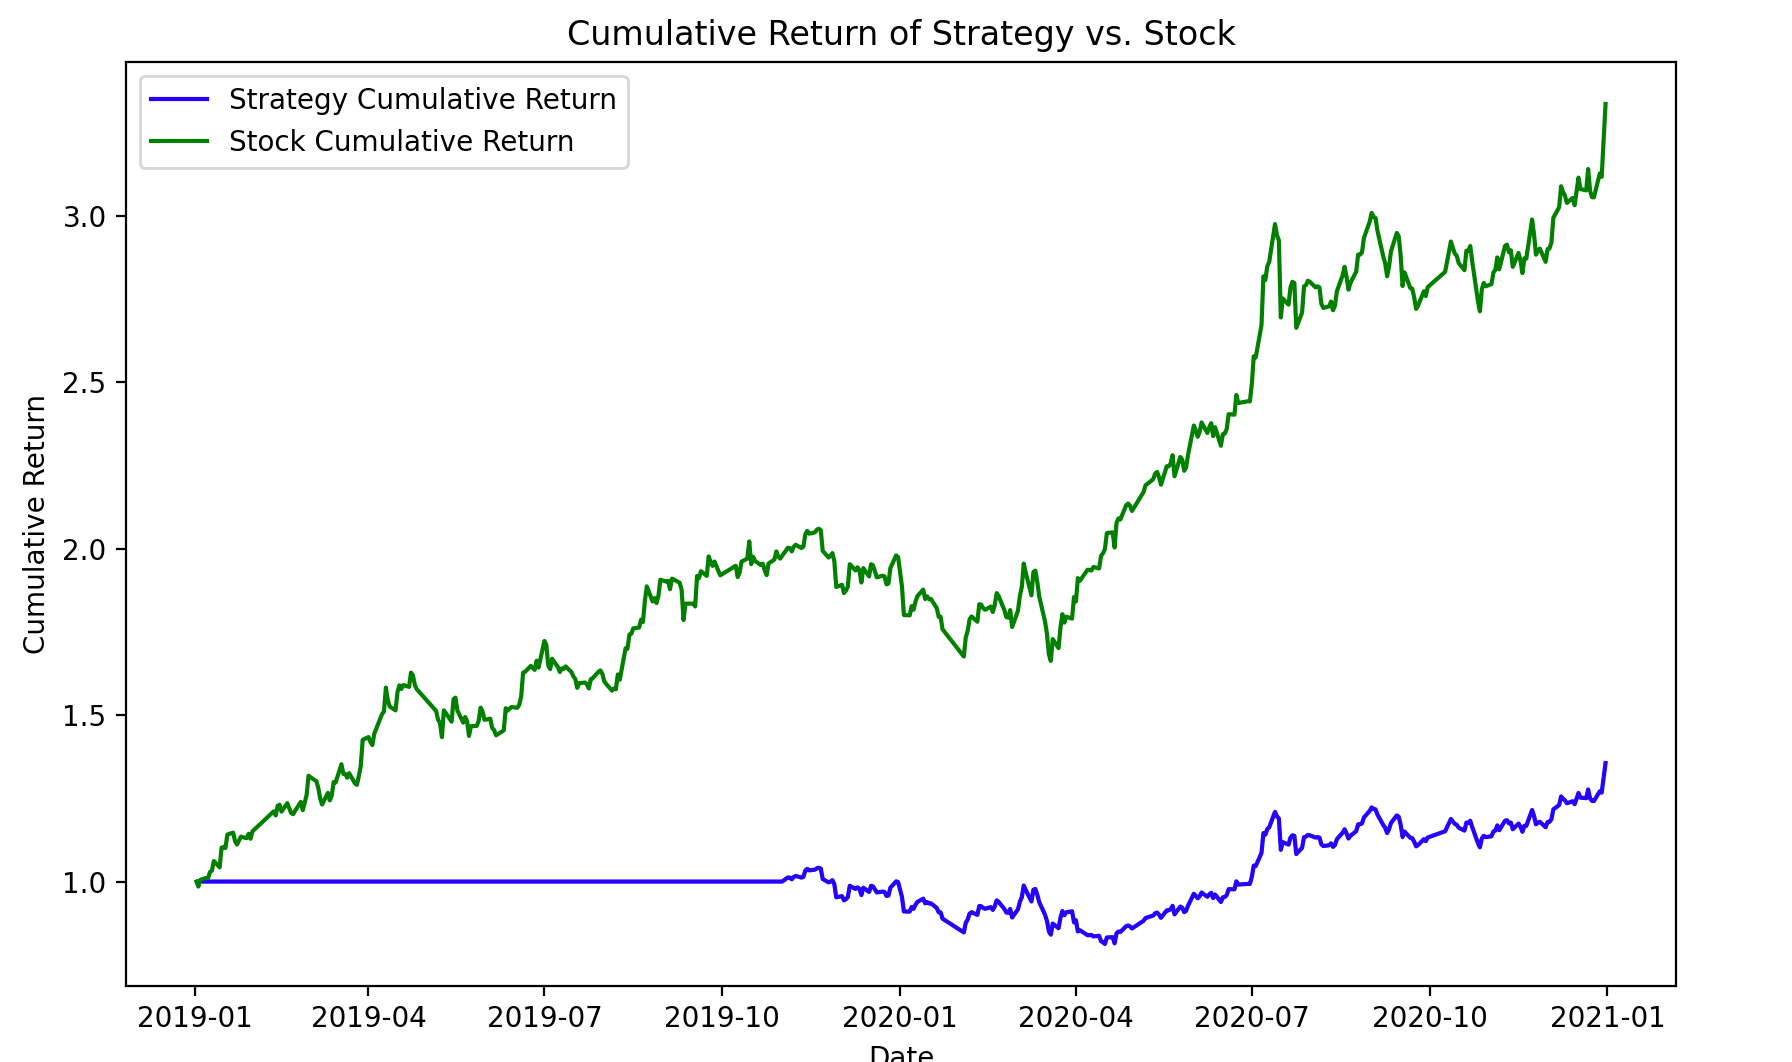
核心细节:data["Signal"].shift(1) 这一行是回测公平性的基石。今天的收益必须由昨天的信号决定,因为今天的信号要等今天收盘后才能算出来,当天不可能按它成交。漏掉这个 shift,回测收益会虚高得离谱,这就是未来函数,下文会专门展开。
计算四大绩效指标
净值曲线只是直观感受,评价策略需要数字。
接着上面的代码,计算年化收益率、年化波动率、夏普比率和最大回撤:
实例
days = len(data) # 回测区间的交易日数
cum = (1 + data["Strategy_Return"]).cumprod() # 策略净值曲线
# 年化收益率:把区间累计收益按复利折算成一年
ann_return = cum.iloc[-1] ** (252 / days) - 1
# 年化波动率:日收益率标准差 x 根号 252
ann_vol = data["Strategy_Return"].std() * np.sqrt(252)
# 夏普比率:每承担一单位波动换来的超额收益,无风险利率取 3%
sharpe = (ann_return - 0.03) / ann_vol
# 最大回撤:净值相对历史峰值的最大跌幅
max_drawdown = (cum / cum.cummax() - 1).min()
print(f"策略累计收益: {(cum.iloc[-1] - 1):.2%}")
print(f"买入持有累计收益: {(data['Close'].iloc[-1] / data['Close'].iloc[0] - 1):.2%}")
print(f"年化收益率: {ann_return:.2%}")
print(f"年化波动率: {ann_vol:.2%}")
print(f"夏普比率: {sharpe:.2f}")
print(f"最大回撤: {max_drawdown:.2%}")
输出结果如下所示:
策略累计收益: 36.29%
买入持有累计收益: 242.46%
年化收益率: 17.45%
年化波动率: 21.71%
夏普比率: 0.67
最大回撤: -22.47%
指标解读如下表:
| 指标 | 本次回测值 | 怎么看 |
|---|---|---|
| 累计收益 | 36.29% | 区间总收益,但单看它容易被区间长短误导 |
| 年化收益率 | 17.45% | 折算到每年的收益,可与任何策略直接对比 |
| 年化波动率 | 21.71% | 净值的颠簸程度,越大持有体验越差 |
| 夏普比率 | 0.67 | 一般大于 1 优秀、0.5 以下谨慎,0.67 属于中规中矩 |
| 最大回撤 | -22.47% | 最惨时亏 22%,想想自己能否扛住 |
一个诚实的结论:这两年茅台本身大涨 242%,双均线策略反而大幅跑输买入持有。趋势策略会错过单边上涨行情中的大部分涨幅,这是策略性格决定的,不是代码写错了。回测的意义正在于此——用数据认清策略的适用边界,而不是证明它无所不能。
回测三大陷阱
回测最大的危险不是算错,而是算得"太漂亮"。以下三个陷阱能让一个垃圾策略在回测里表现得像印钞机。
未来函数
未来函数指计算信号时用到了信号产生时刻还不可能知道的数据。
它是最隐蔽也最致命的陷阱,常见形态与正确写法对比如下:
| 写法 | 代码 | 问题 |
|---|---|---|
| 错误 | data["Signal"] = (data["Close"].shift(-1) > data["Close"]).astype(int) | 用明天的收盘价判断今天的信号,等于提前看答案 |
| 正确 | data["Position"] = data["Signal"].shift(1) | 今天收盘算出信号,次日才执行,信号与可执行性对齐 |
判断标准只有一句话:在每个时间点,策略用到的所有数据都必须不晚于该时刻。
使用当日收盘价算均线再在当日成交,同样属于轻微的未来函数——实盘中你无法保证恰好以收盘价成交,严谨的做法是次日以开盘价成交。
过拟合与数据窥探
把均线参数从 50/200 调到 48/195,回测收益提高了 5 个点,再微调一次又提高 3 个点——如果沿着这条路走到黑,你优化的不是策略,而是这段历史数据的噪声。
这就是过拟合:参数完美适配了过去,但对未来毫无预测力。
与之相伴的是数据窥探(Data Snooping):反复尝试不同策略和参数,直到某一次回测结果好看为止,试的次数越多,撞上"偶然好看"的概率越大。
防范方法是样本内 / 样本外分离:只用前一段数据调参数(样本内),调好后放到从未参与优化的后一段数据上验证(样本外),样本外表现才接近真实水平。更严谨的做法是滚动向前验证(Walk-Forward)。
幸存者偏差
如果只用"今天还活着的股票"做历史回测,就悄悄剔除了所有退市股。
退市股往往是暴跌的那批,剔除它们会让回测收益系统性偏高。
防范方法是在股票池中加入历史退市股票,或使用包含退市股的专业数据源。
还有一个隐形陷阱:交易成本。上面的回测没有计算佣金和滑点,双均线这类低频策略影响尚小,而高换手策略在计入万三佣金加滑点后,回测收益可能直接由正转负。任何回测都应设置与实际一致的费率。

点我分享笔记